
Relativer Zeitraum
Index-Datum
Das Index-Datum beschreibt das genaue Datum eines Ereignisses und bezieht sich auf einen einzelnen Versicherten.
Vorbeobachtungszeitraum
Der Vorbeobachtungszeitraum tritt immer im Zusammenhang mit einem Index-Datum auf. Es bezeichnet den Zeitraum vor dem Index-Datum und schließt je nach Einstellung von Zugehörigkeit Indexdatum das Quartal in dem das Index-Datum liegt mit ein oder nicht. Versicherte mit verschiedenen Index-Daten haben dementsprechend unterschiedliche Vorbeobachtungszeiträume.
Nachbeobachtungszeitraum
Der Nachbeobachtungszeitraum tritt immer im Zusammenhang mit einem Index-Datum auf. Es bezeichnet den Zeitraum nach dem Index-Datum und schließt je nach Einstellung von Zugehörigkeit Indexdatum das Quartal in dem das Index-Datum liegt mit ein oder nicht. Versicherte mit verschiedenen Index-Daten haben dementsprechend unterschiedliche Nachbeobachtungszeiträume.
Zugehörigkeit Indexdatum
Bestimmt die Zugehörigkeit des Quartals, in dem das Index-Datum liegt. Es gibt die folgenden Einstellungsmöglichkeiten:
- Vorbeobachtungszeitraum: Das Quartal des Index-Datum zählt zum Vorbeobachtungszeitraum
- Neutral: Das Quartal des Index-Datum zählt weder zum Vorbeobachtungszeitraum, noch zum Nachbeobachtungszeitraum
- Nachbeobachtungszeitraum: Das Quartal des Index-Datum zählt zum Nachbeobachtungszeitraum
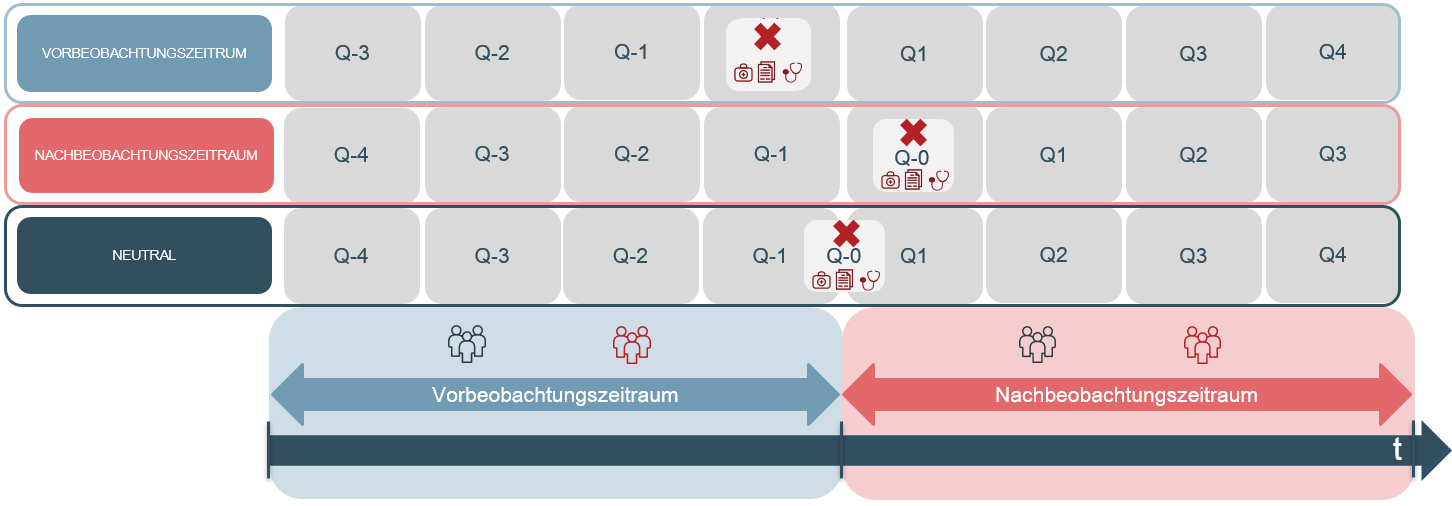
- Vorbeobachtungszeitraum:
Das Indexdatum (bzw. das Quartal mit dem Indexdatum) ist Teil des Vorbeobachtungszeitraums. Im Zuge des PSM wird somit nach Ereignissen am Indexdatum (bzw. im Quartal mit dem Indexdatum) adjustiert. Dies führt tendenziell eher zu geringeren Unterschieden zwischen den beobachteten Gruppen (Null-Effekt).
Vorteilhaft ist, dass im Quartal des Indexevents keine vor dem Indexdatum liegenden Ereignisse fälschlicherweise dem Nachbeobachtungszeitraum zugeordnet werden.
Als Nachteil ist zu nennen, dass Ereignisse, die im Quartal des Indexdatums nach dem eigentlichen Indexdatum liegen, fälschlicherweise im Vorbeobachtungszeitraum gezählt werden und hierfür gegebenenfalls eine Adjustierung erfolgt. Neutral:
Bei der Einstellung Neutral werden alle Ereignisse am Indexdatum (im Quartal des Indexdatums) nicht mitberücksichtigt.
Der Vorteil: Es kann somit keine fälschliche Einteilung in den Vor- oder Nachbeobachtungszeitraum erfolgen. Analytisch ist dies oft am saubersten, da eine korrekte Zuordnung in Vor- und Nachbeobachtungszeitraum bei einer Mischung von quartals- und tagesgenau vorliegenden Informationen kaum möglich ist.
Als Nachteil ist jedoch zu nennen, dass der Tag des Indexdatums (das Quartal des Indexdatums) nicht mehr in der Analyse berücksichtigt wird.Nachbeobachtungszeitraum:
Das Indexdatum (bzw. Quartal mit dem Indexdatum) ist Teil des Nachbeobachtungszeitraums.
Als Vorteil ist zu nennen, dass Ereignisse, die im Quartal des Indexdatums aber nach dem eigentlichen Indexdatum liegen, nicht fälschlicherweise zum Vorbeobachtungszeitraum gezählt werden und hierfür somit keine Adjustierung erfolgt.
Als Nachteil ist zu nennen, dass Ereignisse, die im Quartal des Indexdatums aber vor dem eigentlichen Indexdatum liegen, fälschlicherweise im Nachbeobachtungszeitraum gezählt werden.
Statistische Verfahren
Winsorisierung
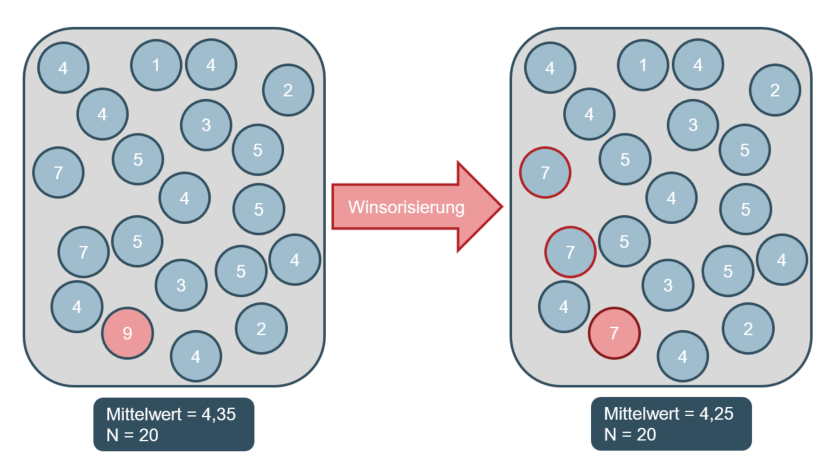
Bei der Winsorisierung werden Extremwerte außerhalb, durch das innerhalb des bestimmten Perzentils enthaltene Maximum ersetzt. Daher ist eine Winsorisierung eine Methode bei der Daten zensiert und nicht einfach ausgeschlossen werden.
- Das 99. Perzentil eines Datensatzes ist der Wert, der die unteren 99% der Datenwerte von den oberen 1% der Datenwerte trennt. Die Winsorisierung setzt alle Werte die größer sind als das 99. Perzentil auf diesen Wert.
- Das 95. Perzentil eines Datensatzes ist der Wert, der die unteren 95% der Datenwerte von den oberen 5% der Datenwerte trennt. Die Winsorisierung setzt alle Werte die größer sind als das 95. Perzentil auf diesen Wert.
Exemplarisch wird eine Winsorisierung für das 99. Perzentil dargestellt. Betrachtet wird ein Datensatz von N = 20 und einem Mittelwert von 4,35. Der Wert, welcher sich oberhalb des 99. Perzentils befindet, ist der Wert 9. Bei der Winsorisierung wird dieser Extermwert nicht ausgeschlossen, sondern durch das berechnete Perzentil ersetzt. Dies bedeutet, dass der Wert durch das im 99% Perzentil enthaltene Maximum mit dem Wert von 7 ersetzt wird. Im Beispiel wird also im Rahmen der Winsorisierung das oberhalb des 99. Perzentils liegende Maximum von 9 durch das berechnete Perzentil mit Wert 7 ersetzt. Hieraus ergibt sich dann eine neue Stichprobe mit weiterhin einem Stichprobenumfang von N = 20, aber einem Mittelwert von 4,25.
Logistische Regression
Dieses statistische Analyseverfahren kann verwendet werden, wenn das Bestehen eines Zusammenhangs zwischen einer erklärten, abhängigen Variablen (Regressand / Kriterium) und einer oder mehreren erklärenden, unabhängigen Variablen (Regressor / Prediktor) überprüft werden soll. Der Wert der abhängigen Variable wird demnach durch die unabhängigen Variablen beeinflusst. Im Falle der binären logistischen Regression muss die abhängige Variable dichotom sein. Das bedeutet, sie kann nur zwei Ausprägungen haben; z.B. könnte die abhängige Variable Apoplex die beiden folgenden Ausprägungen vorweisen: 1 = "ja, hatte bereits einen Apoplex" und 0 = "nein, hatte keinen Apoplex".
Die logistische Regression basiert auf der logistischen Funktion. Deren Besonderheit besteht darin, dass ihr Wertebereich für alle Werte von minus bis plus unendlich zwischen 0 und 1 liegt. Als Ergebnis liefert eine binäre logistische Regression daher die Wahrscheinlichkeit für einen der beiden Werte der unabhängigen Variable.
Interpretation der Ergebnisse: Bei negativem Vorzeichen der Regressionskoeffizienten β sinkt die Wahrscheinlichkeit, dass die abhängige Variable den Wert 1 annimmt, mit steigenden Werten der unabhängigen Variable. Bei positivem Vorzeichen der Regressionskoeffizienten β steigt die Wahrscheinlichkeit, dass die abhängige Variable den Wert 1 annimmt, mit steigenden Werten der unabhängigen Variable.
Differenz von Differenzen (DvD)
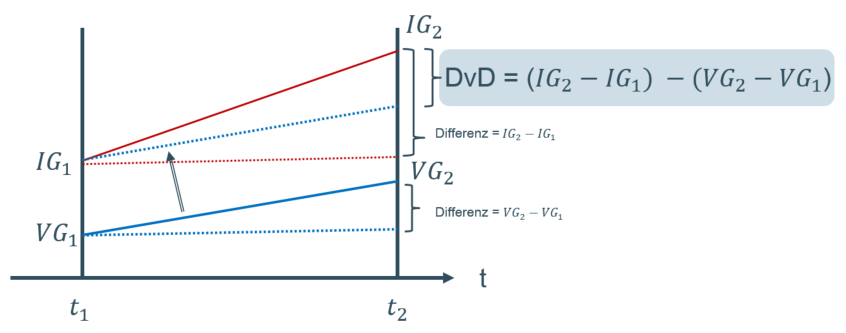
Die Differenz von Differenzen zeigt den Unterschied einer Zielvariable im Nachbeobachtungszeitraum unter Berücksichtigung von bestehenden Unterschieden im Vorbeobachtungszeitraum in beiden Beobachtungsgruppen. Zur Berechnung wird vom Wert der Interventionsgruppe im Nachbeobachtungszeitraum deren Wert aus dem Vorbeobachtungszeitraum abgezogen. Hiervon subtrahiert wird anschließend die Differenz der Werte der Kontrollgruppe aus dem Nachbeobachtungszeitraum und deren Vorbeobachtungszeitrum. Durch dieses Verfahren lassen sich die bestehenden Unterschiede vor der Intervention zwischen den beiden Gruppen herausrechnen. Bei einem Wert der DvD von 0 liegen keine messbaren Unterschiede bezogen auf die betrachtete Variable in beiden Gruppen vor.
Standardisierte Mittelwertdifferenz (SMD)
Die +SMD+ berechnet sich aus der Differenz zwischen dem Mittelwert der Variable in der Interventionsgruppe und deren Mittelwert in der Vergleichsgruppe, welche dann durch die Standardabweichung beider Gruppen geteilt wird. Die Ergebnisse können im Nachbeobachtungszeitraum nach Cohen folgendermaßen interpretiert werden: Ist der Wert der SMD < 0,2 so gibt es keinen messbaren Effekt; 0,2 bis 0,5 geringer Effekt; 0,5 bis 0,8 mittlerer Effekt und > 0,8 großer Effekt (Cohen J. (1969): Statistical power analysis for the behavioral sciences. Academic Press, New York, London, S.38.). Häufig werden diese Werte zur Messung der Effektstärke als Cohens d bezeichnet. Für deren Interpretation wird der Absolutbetrag der +SMD+ betrachtet, dies bedeutet, dass ein negatives Vorzeichen zur Einstufung der Effektstärke weggelassen wird und beispielsweise der Wert SMD = -0.3 nicht als "kein messbarer Effekt", sondern als "geringer Effekt" interpretiert wird. Hierbei ist jedoch zu beachten, dass die Richtung des Unterschiedes entgegengesetzt gepolt ist. Im Vorbeobachtungszeitraum gibt die SMD Auskunft darüber, wie gut die Matchingpartner:innen übereinstimmen, also wie gut die Balancierung bezogen auf die betrachtete Variable erfolgt ist. Ist der Wert der SMD < 0,1, so wird von einer hinreichenden Balancierung gesprochen. Wäre die SMD = 0 im Vorbeobachtungszeitraum, so stellt dies ein optimales Matching der betrachteten Variable dar.
Statistische Lageparameter
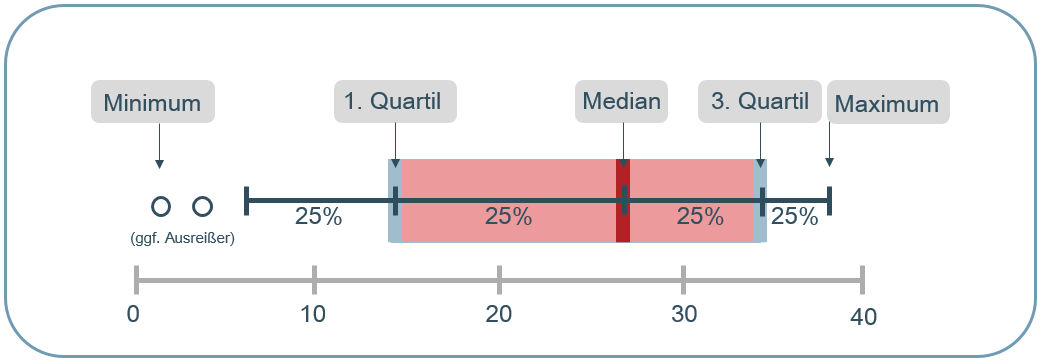
| Statistischer Lageparameter | Beschreibung |
|---|---|
| Mittelwert | Zur Berechnung des Mittelwerts, auch arithmetisches Mittel genannt, bildet man die Summe aus allen Zahlenwerten einer Variable und teilt diese anschließend durch die Anzahl aller Werte. Somit beschreibt der Mittelwert den statistischen Durchschnittswert eines Merkmals innerhalb des betrachteten Datensatzes. |
| Median | Der Median beschreibt den Wert, der genau in der Mitte einer Datenverteilung liegt. Dies bedeutet, dass 50% aller Individualdaten kleinere und 50% größere Werte haben als der Median. Der Median wird daher gelegentlich auch als Zentralwert bezeichnet. |
| Quartil | Quartile teilen einen Datensatz in vier gleich große Teile, die je 25% der Individualdaten enthalten. Das erste Quartil, oder auch unteres Quartil genannt, bezeichnet den Wert, unterhalb dessen sich 25% und oberhalb dessen sich 75% der analysierten Individualdaten befinden. Der Median kann auch als zweites Quartil bezeichnet werden, unterhalb und oberhalb dieses Wertes befinden sich je 50% der Daten. Das dritte Quartil ist der Wert unterhalb dessen 75% und oberhalb 25% der betrachteten Individualdaten liegen. |
| Minimum | Bezeichnet den geringsten zu beobachtenden Wert innerhalb einer zugrundeliegenden Datenmenge. |
| Maximum | Bezeichnet den höchsten zu beobachtenden Wert innerhalb einer zugrundeliegenden Datenmenge. |
Mittelwert
Zur Berechnung des Mittelwerts, oder auch arithmetisches Mittel genannt, bildet man die Summe aus allen Zahlenwerten einer Variable und teilt diese anschließend durch die Anzahl aller Werte. Somit beschreibt der Mittelwert den statistischen Durchschnittswert eines Merkmals innerhalb des betrachteten Datensatzes.
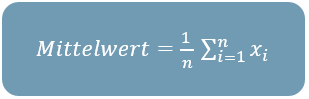
Median
Der Median beschreibt den Wert, der genau in der Mitte einer Datenverteilung liegt. Dies bedeutet, dass 50% aller Individualdaten kleinere und 50% größere Werte haben als der Median.
Quartil
Quartile teilen einen Datensatz in 4 gleich große Teile, die je 25% der Individualdaten enthalten. Das 1.Quartil, oder auch unteres Quartil genannt, bezeichnet den Wert, unterhalb dessen sich 25% und oberhalb dessen sich 75% der analysierten Individualdaten befinden. Der Median kann auch als 2. Quartil bezeichnet werden, unterhalb und oberhalb dieses Wertes befinden sich je 50% der Daten. Das 3.Quartil ist der Wert unterhalb dessen 75% und oberhalb 25% der betrachteten Individualdaten liegen.
Minimum
Bezeichnet den geringsten zu beobachtenden Wert innerhalb einer zugrundeliegenden Datenmenge.
Maximum
Bezeichnet den höchsten zu beobachtenden Wert innerhalb einer zugrundeliegenden Datenmenge.
Standardabweichung
Die Standardabweichung beschreibt die durchschnittliche Abweichung der Ausprägungen einer Variable von deren Mittelwert. Sie liefert demnach ein Intervall und gibt somit die Streubreite der Ergebnisse rund um deren Mittelwert an.
Caliper
Die maximal tolerierte Differenz zwischen den gematchten Proband*innen in einem PSM wird als Caliper bezeichnet. Je kleiner der Caliper eingestellt ist, desto ähnlicher müssen sich die Personen sein, damit es zu einem Match kommt. Erfahrungsgemäß können nicht für alle Teilnehmer:innen ausreichend gute Vergleichspartner:innen gefunden werden, i.d.R. sollten für 90% der Teilnehmenden statistisch ähnliche Vergleichspartner:innen ermittelt werden. Für das PSM wird eine Caliper-Weite von 0,2 Standardabweichungen des Logit empfohlen. Wenn Sie die Stichprobe vergrößern möchten, können Sie den Caliper erhöhen. Beachten Sie jedoch, dass dies mit einer schlechteren Matching-Balance einhergeht, da sie größere Unterschiede der Matching-Partner:innen zulassen
Varianz-Quotient
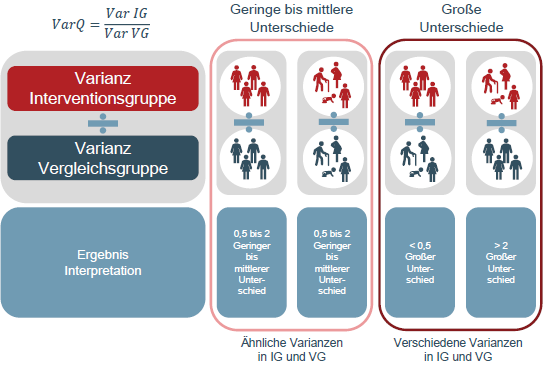
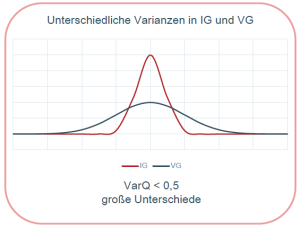
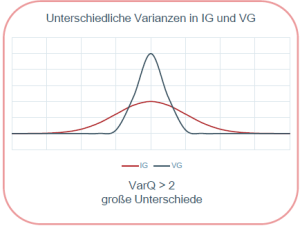
Der Varianz-Quotient (VarQ) ist der Quotient aus der Varianz der Interventionsgruppe (Var IG) und der Varianz der Vergleichsgruppe (Var VG).
| Wertebereich | Interpretation | |
|---|---|---|
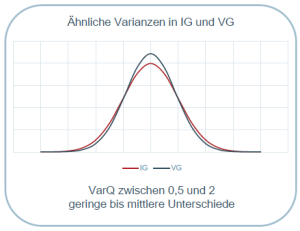
| 0,5 bis 2 | Die beiden Gruppen sind sich bezüglich Ihrer Varianz ähnlich. Anders formuliert, es liegen geringe bis mittlere Unterschiede bezogen auf die Varianz der Gruppen vor. In diesem Wertebereich sollte sich der VarQ in Ihrer durchgeführten Analyse befinden. |
|
| < 0,5 | Es liegt ein großer Unterschied zwischen den Varianzen der IG und der VG vor. In diesem Fall ist die Varianz der VG deutlich höher als die der IG. |
|
| > 2 | Es liegt ebenfalls ein großer Unterschied der Varianzen der IG und der VG vor. In diesem Fall ist die Varianz der IG deutlich höher als die der VG. |
|
P-Wert
Der p-Wert ist die Aussage eines statistischen Tests, der die Wahrscheinlichkeit angibt, für die eine bestimmte Nullhypothese zutreffend ist. In der wissenschaftlichen Praxis wird die Nullhypothese dann verworfen, wenn der p-Wert kleiner als 0.05 ist. Beim Propensity Score Matching misst der Test wie ähnlich sich die beiden Stichproben einer Variable der Interventionsgruppe und Vergleichsgruppe sind. Die Nullhypothese besagt hier, dass die beiden Stichproben aus derselben Verteilung kommen, also ähnlich sind. Wenn der p-Wert kleiner als 0.05 ist, können wir somit einen signifikanten Unterschied zwischen Interventionsgruppe und Vergleichsgruppe feststellen.
Bei der Balance-Tabelle (siehe Balance interessiert uns vor allem der p-Wert nach dem Matching, da wir wissen wollen, wie ähnlich sich die beiden Gruppen, bezogen auf die jeweilige Variable, sind. Ein Wert über 0.05 bedeutet, dass sich die beiden Gruppen bei dieser Variable noch nicht ähnlich sind.
Beim Vergleich der Zielvariablen werden ähnliche Stichproben im Vorbeobachtungszeitraum (hier also einen hohen p-Wert) erwartet. Unter dieser Voraussetzung würde ein niedriger P-Wert im Nachbeobachtungszeitraum auf einen signifikanten Unterschied der beiden Stichproben und damit auf einen signifikanten Effekt der Intervention auf die Interventionsgruppe hinweisen.
Statistische Streuungsparameter
| Statistischer Streuungsparameter | Beschreibung |
|---|---|
| Standardabweichung | Die Standardabweichung beschreibt die durchschnittliche Abweichung der Ausprägungen einer Variable von deren Mittelwert. Sie liefert demnach ein Intervall und gibt somit die Streubreite der Ergebnisse rund um deren Mittelwert an. |
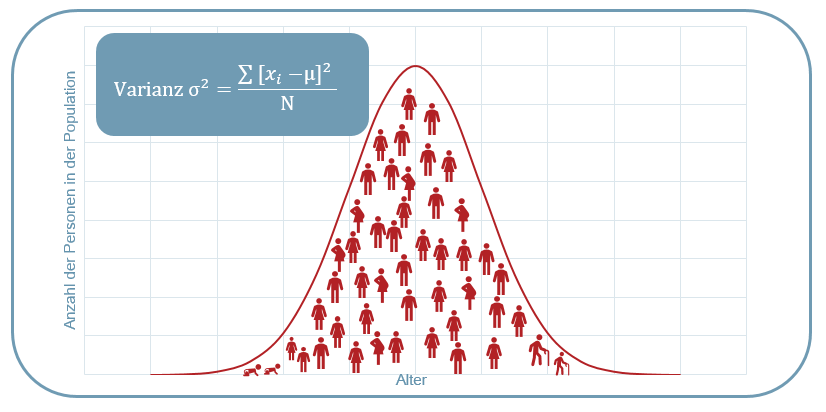
| Varianz | Die Varianz beschreibt die Verteilung von Werten um deren Mittelwert. Sie ist das Quadrat der Standardabweichung |
Variablentypen
| Variablentyp | Beschreibung |
|---|---|
| Stetig | Als stetig wird eine Variable bezeichnet, wenn sie zwischen zwei beliebigen numerischen Werten unendlich viele Ausprägungen annehmen kann. Hierzu zählen z.B. Uhrzeit- und Datumswerte oder andere numerische Werte wie beispielsweise das Alter einer Person. |
| Binär | Als binär wird eine Variable bezeichnet, wenn sie nur zwei Möglichkeiten der Ausprägung besitzt. Beispielsweise zählen hierzu ja/nein Antworten oder die Zuweisung einer Person entweder in eine Interventionsgruppe oder eine Kontrollgruppe. |
Binär
Als binär wird eine Variable bezeichnet, wenn sie nur zwei Möglichkeiten der Ausprägung besitzt. Beispielsweise zählen hierzu ja/nein Antworten oder die Zuweisung einer Person entweder in eine Interventionsgruppe und eine Kontrollgruppe.
Stetig
Als stetig wird eine Variable bezeichnet, wenn sie zwischen zwei beliebigen numerischen Werten unendlich viele Ausprägungen annehmen kann. Hierzu zählen z.B. Uhrzeit- und Datumswerte oder andere numerische Werte wie beispielsweise das Alter einer Person.
Confounder
Ein Confounder ist ein Störfaktor, welcher sowohl mit der Intervention, als auch mit dem Zielkriterium assoziiert ist und somit zu einer Verzerrung der Schätzung des Effekts der Intervention führen kann. Daher wird in Studien stets versucht mögliche Confounder zu vermeiden. Möglicherweise kann der HDPS Algorithmus bei der Ermittlung von Confoundern hilfreich sein (siehe HDPS Variablenselektion.
Logische Operatoren
Logische oder Operatoren verknüpfen Bedingungen auf eine bestimmte Art miteinander.
| Operator | Beschreibung | |
|---|---|---|
| UND | Alle Bedingungen müssen erfüllt sein |
|
| ODER | Entweder eine, mehrere oder alle Bedingungen müssen erfüllt sein |
|
| NICHT | Keine der Bedingungen darf vorliegen |
|
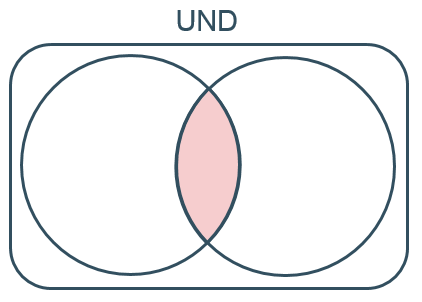
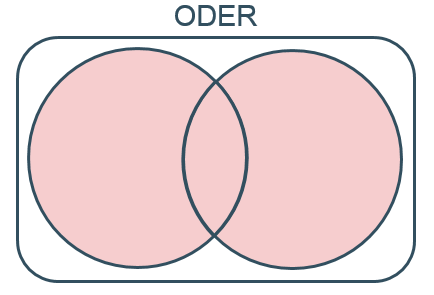
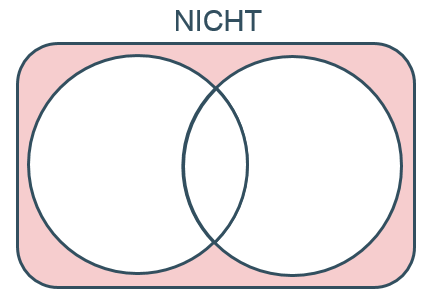
Der Datenbereich, welcher in der Analyse eingeschlossen wird, ist in den Grafiken als roter Bereich dargestellt.
Propensity Score Matching
Matching

Beim Matching wird versucht zu jeder Person in der Interventionsgruppe eine vergleichbare Person in der Vergleichsgruppe zu finden.
Propensity Score
Der Propensity Score einer Person ist die Zusammenfassung aller Einflussvariablen auf einen einzelnen Wert, bezogen darauf ob die Person der Intervention ausgesetzt war oder nicht. Beim Propensity Score Matching wird davon ausgegangen, dass Personen mit ähnlichen Einflussvariablen auch einen ähnlichen Propensity Score haben. Für die Berechnung des Scores wird eine Logistische Regression verwendet, die anhand der Einflussvariablen bestimmt ob eine Person der Interventions- oder Vergleichsgruppe angehört. In dem Score werden somit vor allem jene Einflussvariablen abgebildet, die auf die Intervention hinweisen.
Der Score liegt immer zwischen 0 und 1 und kann lose als Wahrscheinlichkeit betrachtet werden, dass die Person die Intervention erhält.
Prädiktion
Zentrierung
Unter der Zentrierung einer Variablen wird eine Transformation verstanden, bei der der Mittelwert der Variablen von jedem einzelnen gemessenen Wert dieser Variablen abgezogen wird. Dadurch wird der Mittelwert der zentrierten Variable auf Null gesetzt.
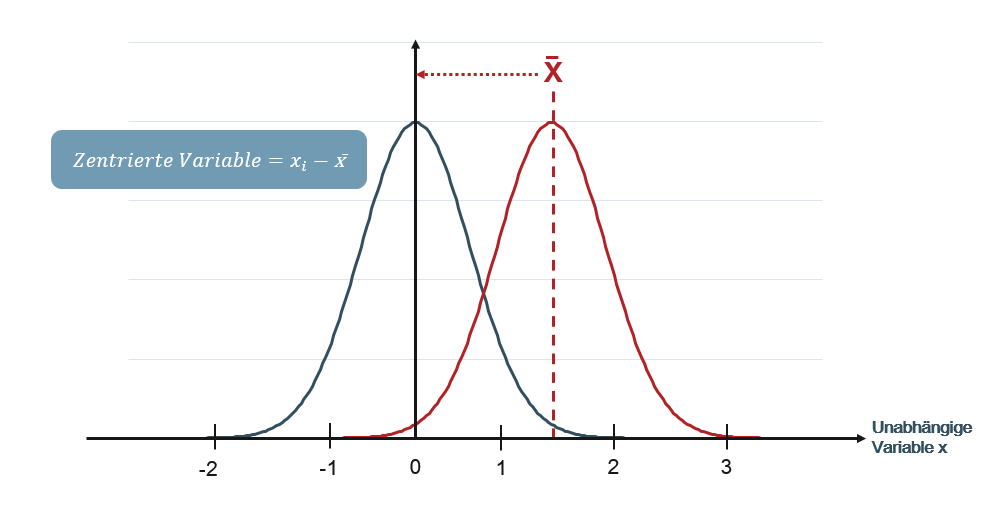
Eine Zentrierung erfolgt nur bei unabhängigen Variablen und hat zum Ziel die Multikollinearität, also den statistischen Zusammenhang (Korrelation) von zwei oder mehreren unabhängigen Variablen, zu entfernen. Dies ist notwendig, da bei vorliegender Multikollinearität ein Modell zwar die Güte der Prädiktion in Bezug auf die Gesamtheit aller unabhängigen Variablen ausgeben kann, es dann jedoch nicht möglich ist, eine präzise Aussage bezüglich der Vorhersagekraft einer einzelnen unabhängigen Variablen zu liefern.
Korrelation
Die Korrelation (nach Pearson) bezeichnet den statistischen Zusammenhang von Variablen. Hierbei können die zwei Dimensionen Richtung und Stärke betrachtet werden.
Richtung des Zusammenhangs:
| Richtung | Beschreibung | Grafische Darstellung |
|---|---|---|
| Positiver Zusammenhang | Je höher (niedriger) der Wert einer Variable, desto höher (niedriger) der Wert der anderen Variable. |
|
| Negativer Zusammenhang | Je höher (niedriger) der Wert einer Variable, desto niedriger (höher) der Wert der anderen Variable. |
|
| Kein Zusammenhang | Eine Veränderung der einen Variable hat keinen Einfluss auf die Veränderung der anderen Variable. |
|
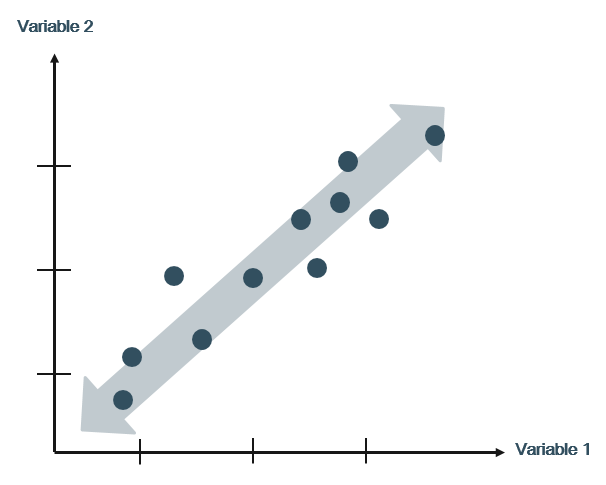
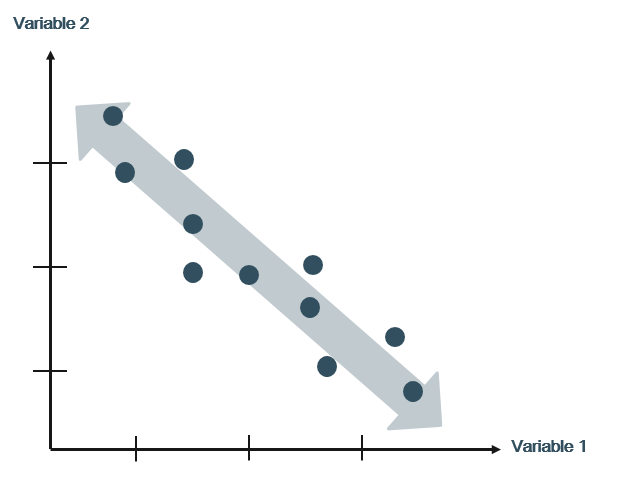
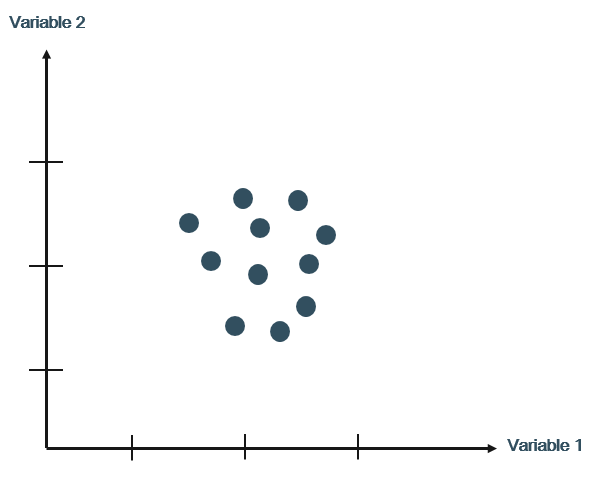
Exemplarisch wurde in der Tabelle die bivariate Korrelation grafisch dargestellt, d.h. der statistische Zusammenhang von zwei Variabeln.
Stärke des Zusammenhangs:
Durch die Standardisierung ist der Pearson-Korrelationskoeffizient einheitlich interpretierbar und kann nur Werte zwischen –1 und +1 annehmen.
| Wert | Beschreibung |
|---|---|
| +1 | Perfekt negativer Zusammenhang |
| -1 | Perfekt negativer Zusammenhang |
| 0 | Kein Zusammenhang |
Nach Jacob Cohen (1988) können die Werte folgendermaßen interpretiert werden:
| Wert | Beschreibung |
|---|---|
| Ab (+/-) 0.10 | Starker Zusammenhang (starker Effekt) |
| Ab (+/-) 0.30 | Mittlerer Zusammenhang (mittlerer Effekt) |
| Ab (+/-) 0.50 | Starker Zusammenhang (starker Effekt) |
Fehler 1. und 2. Art
| Nullhypothese wahr | Nullhypothese nicht wahr | |
|---|---|---|
| Ergebnis liegt innerhalb der Stichprobe im Annahmebereich der Nullhypothese | Getroffene Entscheidung ist richtig. (Annahme und Nullhypothese ist wahr) = Spezifität | Getroffene Entscheidung ist falsch. (Annahme und Nullhypothese ist nicht wahr) = Fehler 2. Art (Falsch Negativ) |
| Ergebnis liegt innerhalb der Stichprobe nicht im Annahmebereich der Nullhypothese | Getroffene Entscheidung ist falsch. (Ablehnung aber Nullhypothese ist wahr) = Fehler 1. Art (Falsch Positiv) | Getroffene Entscheidung ist richtig. (Ablehnung und Nullhypothese ist nicht wahr) = Sensitivität |
Die Nullhypothese besagt, dass ein beobachteter Unterschied allein auf den Zufall zurückzuführen ist und demnach der betrachtete Faktor keinen Einfluss auf das Ergebnis hat. Häufig wird als Signifikanzniveau für Hypothesentests alpha = 0.05 angenommen (= Annahmebereich). Liegt der P-Wert des Hypothesentests unterhalb dieses Signifikanzniveaus (P-Wert < 0.05), so wird die Nullhypothese verworfen.
Es wird demnach davon ausgegangen, dass der beobachtete Unterschied NICHT auf Zufall zurückzuführen ist, sondern im Zusammenhang mit dem betrachteten Faktor steht. Wird dieser Wert jedoch überschritten oder erreicht (P-Wert >= 0.05) so kann nicht ausgeschlossen werden, dass der Unterschied rein zufällig entstanden ist. In diesem Fall wird die Nullhypothese angenommen.
Der Fehler 1. Art wird daher häufig auch als Alphafehler bezeichnet, denn dieser bedeutet eine fälschliche Ablehnung der Nullhypothese, welches mit der Wahrscheinlichkeit des Siginfikanzniveau alpha passieren kann. Je kleiner demnach das Signifikanzniveau alpha gewählt wird, desto höher wird die Sensitivität und desto seltener treten Falsch Positive Fälle auf.